“你们能不能在三天内解决这个问题?如果不能,我们就换人了。”
会议室里,XX医院信息科李主任的声音很平静,但每个字都像一块石头,砸在我们项目经理小张的心上。窗外的春日阳光斜斜地照进来,照亮了空气中漂浮的尘埃,却照不进会议室里压抑的气氛。空调吹出的冷风扫过每个人的后背,让人不寒而栗。
这是合同签订后的第二个月,我们的HIS系统在XX医院上线测试的第五天。第五天,一个我们从未遇到过的数据同步问题浮出水面——门诊缴费数据无法实时同步到住院系统。简单说,病人在门诊交了费,住院处查不到,导致重复收费、漏收费,护士站怨声载道,财务科王科长已经来投诉三次了。
我们派出的工程师小刘已经熬了三个晚上,问题依旧。他黑着眼圈,头发凌乱,手指在键盘上飞舞,屏幕上的日志滚动如瀑布。测试环境一切都好,一到生产环境就出问题。日志里只有一堆”timeout”和”connection reset”,看不出所以然。
李主任给我们下了最后通牒:”三天,要么解决问题,要么走人。”他的眼神里没有威胁,只有一种深深的疲惫——那是被问题折磨了一个月后的绝望。
1. 表面的技术问题,背后是管理混乱
回公司的路上,车里没人说话。
车窗外的城市灯火璀璨,但车内一片阴沉。我们在技术圈子里摸爬滚打这么多年,什么疑难杂症没见过?数据库死锁、网络分区、应用OOM…但为什么这次被一个简单的数据同步卡住了?
小张盯着窗外飞驰而过的街景,思绪万千。他想起三年前在另一家医院做数据迁移时,也遇到过类似问题,但那次只用了半天就定位了。这次为什么这么难?
小刘突然说:”哥,我总觉得问题不在代码里。”
“那在哪里?”
“在医院网络的防火墙策略。我怀疑他们在应用层做了流量限制,或者中间有某个设备在做SSL拦截。”
小刘是公司最年轻的高级工程师,26岁,话不多,但一针见血。他打开笔记本电脑,快速画出数据流向图:从门诊收费终端,到HIS应用服务器,再到住院数据库,中间经过三道网络设备——防火墙、WAF、负载均衡。
“如果中间有设备做深度包检测,可能会拦截某些SQL语句。”小刘说。
张哥点点头:”但为什么测试环境没问题?”
“因为测试环境没有那三道设备,直接连数据库。”
2. 七台设备,两个未知节点
第二天一早,我们没带电脑,只带了笔记本和笔,直接去了XX医院的网络机房。
机房在住院部地下二层,恒温恒湿,蓝色LED灯闪烁。机房管理员老陈是个四十多岁的中年人,戴着眼镜,表情很冷淡,正在低头修一台交换机。
听说我们要查网络设备,他直摇头:”你们厂商就是喜欢折腾设备。问题是你们的软件有问题。”
“陈师傅,”小刘递上一支红塔山,”我们不急,就想看看贵院的网络拓扑,特别是HIS系统这条链路上有哪些设备。”
老陈犹豫了一下,接过烟:”跟你们说了也没用,这是内部网络结构,涉密。”
“我们签了保密协议。”李主任也来了,掏出协议给他看。
他扫了一眼,终于松口:”好吧,就看看,不能拍照。”
老陈拿出一张A3纸,画了一张拓扑图,用不同颜色的笔标注:
从HIS服务器(位于信息中心机房)到住院收费终端(分布在门诊楼、住院楼各楼层),中间经过七台设备:
1. 核心交换机(华为S7700,位于信息中心)
2. 防火墙(深信服AF-1000,位于信息中心)
3. WAF(Web应用防火墙,自研,位于安全接入区)
4. 负载均衡(F5 BIG-IP,位于应用前端)
5. 路由交换机(思科Catalyst 6500,住院楼核心)
6. 二层交换机(华为S5700,各楼层)
7. 住院收费终端(PC机,运行Windows 10)
问题出在数据从第3台WAF到第4台负载均衡之间。我们的服务调用住院数据库接口,先过WAF做安全检测,再过负载均衡分发到住院应用服务器。
小刘指着WAF和负载均衡之间的连线:”这里,我们要抓包。”
“抓不了。”老陈说,”WAF是省信息中心统一部署的,我们没有管理权限,只有使用权限。抓包要找省里审批。”
“那WAF的策略是谁维护?”
“省信息中心安全科。他们每季度更新一次规则,但从不告诉我们具体规则是什么。”
张哥心里一沉。这意味着我们要联系省里,走流程,申请排查。七天?一个月?都不够。
小刘却笑了:”哥,我有个想法。”
3. 绕开防火墙,但不能绕过规则
小刘的想法是:不直接连接住院数据库,通过门诊数据库做中转。
“如果我们把门诊缴费成功的记录,先存到门诊库,然后让医院现有的数据同步工具(他们有个ETL任务,每5分钟同步一次),把数据从门诊库同步到住院库呢?”
张哥摇头:”住院实时缴费怎么办?病人缴费后要马上生成住院预交金,如果同步有延迟,病人没法办理手术。”
“我们可以加一个中间表,记录所有待同步的数据,再写一个监听程序,确保每条缴费记录都同步到住院库。同步失败就重试,重试三次还失败,就人工介入。”
“但如果数据不一致,财务对账会出大问题。”
“我们可以做到99.99%一致。”小刘眼神坚定,”我在之前项目用过类似方案。”
张哥知道,这方案最大的风险在于:这只是一时之计。如果长期这样,数据延迟会导致住院处无法实时掌握病人费用,影响医疗决策。
而且,一旦住院库有问题,门诊库也会被拖累——数据链路变长了,故障点变多了。
“这个方案能撑多久?”
“至少撑到我们拿到省里的WAF策略调整许可。”小刘说,”我打听到,省信息中心下个月要做一次WAF规则优化,我们可以把我们的情况报上去,申请白名单。”
张哥想想,这也是无奈之举。
4. 说服的关键:不是技术,是态度
我们带着方案去见李主任。
这一次,张哥没有带笔记本,而是带了一叠A4纸,上面手绘了数据流对比图:现状(直接连住院库)vs 临时方案(门诊库中转)。
他开门见山:”李主任,我们有两个方案。方案A:继续等省里审批,预计时间1-2个月,期间系统会持续不稳定。方案B:我们先上线一个临时方案,绕过WAF的误拦截,保证业务正常,同时我们去省里协调。”
李主任皱眉:”临时方案会不会影响数据安全?”
“不会。数据仍在医院内网流转,只是多了一步中转。而且,我们会加日志记录,所有数据流动可追溯。”
“那什么时候能彻底解决?”
“如果省里配合,一个月内。如果不配合,我们只能长期用这个方案,但我们会持续优化,确保延迟在3秒内。”
李主任看向网络管理员老陈:”你觉得呢?”
老陈说:”WAF确实是我们控制不了的。我建议先临时方案,同时周总你们去省里跑,我们医院也给省里发个函,说明业务影响。”
5. 72小时不眠不休
接下来的72小时,是我们职业生涯中最漫长的一段。
小刘带人写中转服务,这是一个Java应用,要监听门诊库的binlog,捕获缴费成功事件,然后写入住院库的中间表,再触发住院库的同步。
张哥在医院现场协调:
– 第一天:改造门诊收费模块,增加数据双写(同时写门诊库和中间表)
– 第二天:开发和部署中转服务,与住院系统联调
– 第三天:数据一致性验证,灰度上线
李主任几乎没回家,吃住都在医院,随时决策。
第三天凌晨四点,系统终于上线。
上线前,我们做了三轮压力测试:
– 模拟门诊高峰,1000个并发缴费请求,中转延迟平均1.2秒,最大3秒
– 住院端查询,数据一致率100%
– 故障切换:如果中转服务挂掉,门诊收费仍能正常进行,只是同步暂停,人工补同步
李主任看着测试报告,紧绷的脸终于有了一丝松动:”上线吧。”
6. 事后复盘,我们做对了什么?
一周后,系统运行稳定。
李主任请我们吃饭。酒桌上,他举杯:”说实话,那三天,我没想到你们能搞定。”
“为什么?”
“换别家厂商,遇到我们这种’受制于省里’的情况,早就推脱了。你们没推脱,而是给我们一个临时方案,让我们业务不停摆。”
张哥说:”关键不是技术方案多巧妙,是不放弃。”
李主任点头:”而且你们没把我们当外人——所有的决策,都让我们参与;所有的风险,都提前告诉我们。这种透明,让我们很放心。”
7. 省里协调:一个月后的好消息
与此同时,张哥跑省里的工作也有了进展。
他找到省信息中心安全科的科长,是一个45岁的技术男。张哥没有直接要策略,而是先做了三件事:
1. 准备数据:统计了XX医院过去一个月因WAF拦截导致的业务异常次数(37次),以及影响的患者数量(约5000人次)
2. 提供方案:写了一份详细的白名单申请,只申请对HIS系统的特定接口放行,并附上了安全自评报告
3. 承诺责任:如果因为放行导致安全事件,由软佳承担全部责任
科长被诚意打动,两周后批复:同意对XX医院HIS系统加白名单,为期一年,期满可续。
消息传来,李主任第一时间打电话给张哥:”你们怎么做到的?”
“周总说过:(‘解决问题,要找到问题的根源’)。问题的根源不是WAF,是沟通。”
8. 这次事件,让我们明白的五个道理
第一,技术问题往往是管理问题的表象
如果XX医院自己有WAF策略管理权,问题早就解决了。但因为他们把安全外包给了省里,就失去了主动性。我们作为供应商,只能适应环境,不能改变环境。
第二,临时方案不是妥协,是策略
永久方案需要时间,但业务不能等。临时方案的价值是赢得时间,同时不让客户受损。很多厂商不愿意做临时方案,觉得”不完美”,但客户才不管完美不完美,客户只要能用。
第三,信任建立在”困难时刻”
如果一切顺利,客户看不出供应商的差别。只有在困难时刻,才知道谁靠得住。那72小时,我们所有人都拼了,这种拼劲,客户 seeing 到了。
第四,跨层级协调是能力
我们不仅要解决技术问题,还要学会和省里、和其他部门协调。这种能力,比技术能力更重要。
第五,透明沟通比技术方案更重要
客户不关心你的技术多高深,客户关心的是:问题能不能解决?什么时候解决?过程中有什么风险?把一切都透明化,客户就不会猜疑。
9. 三个月后:系统稳定,客户满意
三个月后,XX医院HIS系统可用率达到99.95%,数据同步延迟平均0.5秒,住院处投诉率为零。
杨院长在一次IT座谈会上说:”我们信息化,最怕两种供应商:一种是技术不行,一种是服务不行。软佳两种都不占。他们技术扎实,服务到位,关键是有担当。”
这次事件,也成了软佳内部的经典案例,被写进新员工培训教材,标题是:《如何在72小时内解决一个看似不可能的问题》。
10. 核心观点:问题的大小,取决于你的态度
小刘后来在一次技术分享会上说:
“很多问题,看起来很大,是因为你把它当成’问题’。
如果你把它当成’任务’,就有思路;
如果你把它当成’机遇’,就有动力;
如果你把它当成’证明自己的机会’,就一定能解决。
(‘态度决定高度,高度决定角度’)。
你用什么样的心态面对问题,问题就会以什么样的结果回报你。”
互动话题
你遇到过最棘手的技术问题是什么?是怎么解决的?
> 基于真实医院场景改编,人物均为化名
立即免费试用门诊系统:https://app.kmhis.com/
International Version:https://app.kmhis.com/multi/
了解软佳门诊管理系统详情:https://www.kmhis.com/outpatient-management-system.html
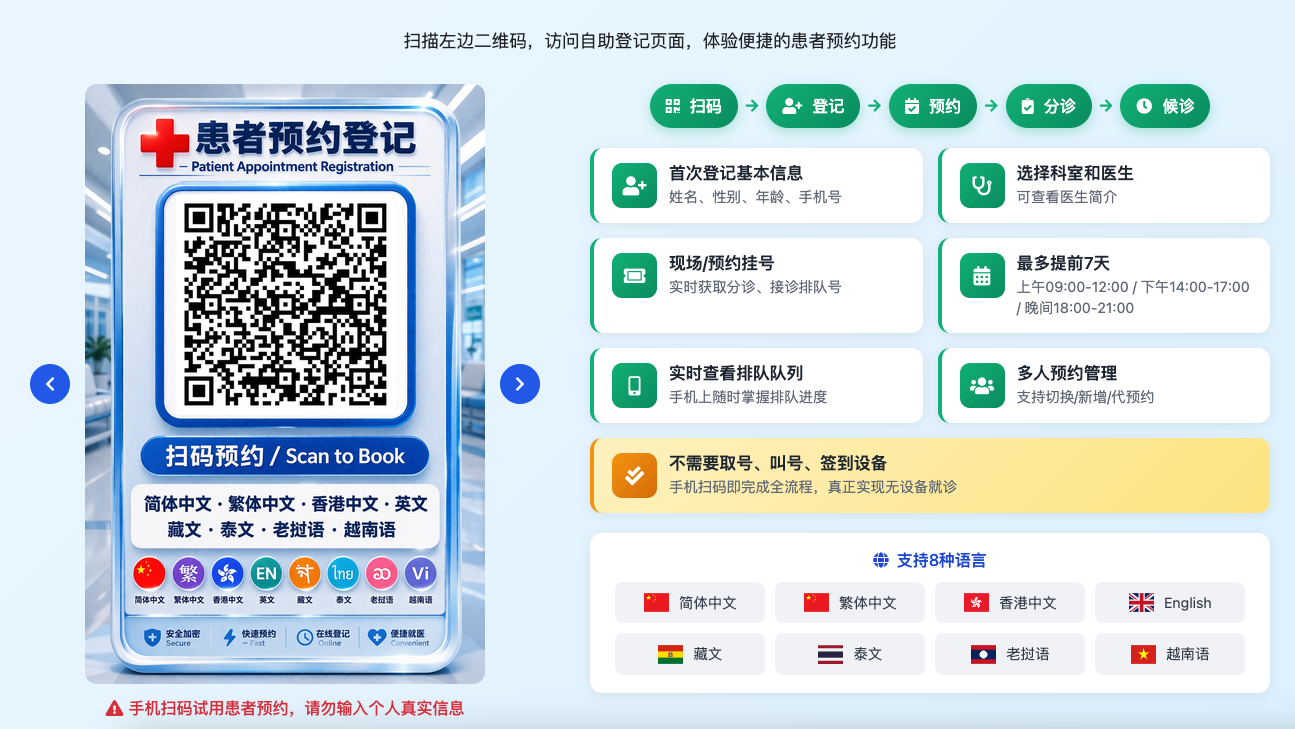
手机扫码试用患者预约。请勿输入个人真实信息(点击图片可查看原图)
支持8种语言:简体中文、繁体中文、香港中文、English、藏文、泰文、老挝语、越南语
说真的。这类问题我见过太多了。每次看到医院同事为选型头疼。我就想,要是早点有人把这些经验分享出来就好了。毕竟。选择不对。后面全是麻烦。选择对了。省心省力。还能提升整个机构的运行效率。希望这篇能帮到正在纠结的你。
你如果有具体需求。也可以去 www.kmhis.com 看看。那里有更详细的技术方案和案例。